本文记录一个生产环境上偶发的 HTTP 异常排障过程。 一个看似偶发的 HTTP 接口异常,从 TCP 连接的各个层面进行分析,最终命中对方反向代理服务器源码。
背景
在使用 HttpClient 通过 WebProxy 高并发调用某个外部接口时,偶尔会出现网络异常 ResponseEnded。
异常堆栈:
|
|
该异常在日志里面相当醒目,均匀分布在所有时间段,并且不上代理就没这个问题。
尝试过使用同样的代码,在本地高并发跑脚本,但是无法复现。 初步认定为 TCP 连接上难以复现的一个并发问题。
这是连接架构背景:
|
|
代理使用 CONNECT 隧道进行连接,正向代理。
排查 & 修复
dotnet-trace
dotnet-trace 可以收集 .NET 进程发出的各种事件,这里捞取 System.Net.Http 相关的所有事件,每个请求都有对应的 connectionId,有助于排查底层 TCP 连接相关问题。
列出 dotnet 进程:
|
|
Trace:
|
|
Trace 20min,结果可以根据 host、connectionId 分组,从 RequestFailedDetailed 事件中可以获取异常堆栈,从而过滤 ResponseEnded 异常。
异常事件不含 connectionId,不过异常会跟随一个 close 事件用作关联。
分析所有连接:
| 目标 host | 是否走代理 | 次数 | 断连年龄 |
|---|---|---|---|
| X | 是(10.0.0.x) | 13 | ~60–66s |
| example.com | 是(10.0.0.x) | 6 | 7.9–40.1s |
| example2.com | 否(直连) | 8 | 0.6–165.4s |
| 建连早于抓取窗口(host 未知) | — | 7 | — |
看目标 X 可以得知规律就是在 60-66s 发生断连。
继续分析指定 host 所有连接:
| 分母 | 失败率 |
|---|---|
| 按请求 13 / 44,997 | ≈ 0.029% |
| 按断连 13 / 558 | ≈ 2.33% |
| 时间维度 | 13 次 / 20 分钟 |
总之就是长连接无法复用了,大概率是和 keep-alive 相关的问题。
HttpClient 的 SocketsHttpHandler 提供了两个相关的参数:
- PooledConnectionIdleTimeout 连接空闲多久会自动回收,默认 1min
- PooledConnectionLifetime 连接固定的生命周期,默认不限制
这几条连接从 trace 可以确保并不空闲,排除第一条。
第二条列为嫌疑犯,继续探索。
TCP 探测脚本
为了探查事件的全貌,还需要更多的信息。 于是我想到了一个可以复用 HttpClient 代码来做 TCP 探测脚本的方法。
探测原理:并发下 HttpClient 的连接复用是黑盒,但是对于串行的请求,必然会选择复用连接。 如果 HttpConnection 存活,就会复用;如果 HttpConnection 失活,就会建立新连接。
代码很简单:
|
|
设置四组对照组实验:
- 对照组:通过 HKProxy 连接 X 站点(产生 ResponseEnded 的路线)
- 实验组 A:通过杭州 Proxy 连接 X 站点
- 实验组 B:通过 HKProxy 连接 Y 站点
- 实验组 C:直连连接 X 站点
对照组:
| 周期 | connId | 目标 | 代理出口 | 建连 → 关闭 | 存活时间 |
|---|---|---|---|---|---|
| 第 1 轮 | 4 | hkproxy 隧道 | 10.0.0.4 | 15:43:40.39 → 15:44:40.65 | 60.27s |
| 第 1 轮 | 5 | X | 10.0.0.4 | 15:43:40.59 → 15:44:40.65 | 60.07s |
| 第 2 轮 | 6 | hkproxy 隧道 | 10.0.0.4 | 15:44:40.82 → 15:45:41.41 | 60.59s |
| 第 2 轮 | 7 | X | 10.0.0.4 | 15:44:40.98 → 15:45:41.41 | 60.43s |
| 第 3 轮 | 8 | hkproxy 隧道 | 10.0.0.1 | 15:45:41.55 → 15:46:41.76 | 60.21s |
| 第 3 轮 | 9 | X | 10.0.0.1 | 15:45:41.71 → 15:46:41.76 | 60.05s |
| 第 4 轮 | 10/11 | X | 10.0.0.3 | 15:46:41.89 → 抓取结束 | 未关 |
数据和 trace 结果完全一致,就是 X 站点长连接存在 60s 硬中断,继续后面的实验组。
实验组:
- 实验组 A:68.5s 仍活
- 实验组 B:>217s 仍活
- 实验组 C:>92.8s 仍活
实验组的测试时间并没有严格要求,只需要测试覆盖到大于 68s 即可。
结论:可以初步排除 HKProxy 本身问题,因为杭州 Proxy 没问题、其他站点连接没问题。
初步猜测:通过 HKProxy 可能连接到了智能 DNS 走 X 的 HK 集群,而该集群正好有配置问题。
修复
既然下游未知原因 60s 断连,那只要 HttpClient 比下游更早回收连接就可以了。
改造生产环境代码,分流指定 host 的 HttpClient 构造函数把 PooledConnectionLifetime 设为低于 60s 的值,例如设置 50s,然后对比测试。
最终异常日志消失!
排查 & 修复到这里就结束了,但文章并不会到此结束,接下来还要探索一下根因。
HttpClient 底层剖析
目前已知连接会在 60s 硬中断,尚不清楚哪方发送的 FIN 导致。
初步怀疑有两种:
- 源站或者代理侧发送了 FIN,正好撞上了 request flighting,产生了竞态
- HttpClient 连接复用时,将尚未标记为失活的请求还在拿出来继续写入请求
因为中间隔了一层代理,使得问题排查难度几何上升。
首先使用 AI 分析堆栈,拉取 dotnet runtime 源码,找出代码抛异常的位置。
消息文本精确匹配一个资源 Strings.resx:309-310 中 net_http_invalid_response_premature_eof = “The response ended prematurely."。 全部抛出点里 HTTP/1.1 只有两处:
- HttpConnection.cs:663(SendAsync 主体内)—— 初始读后 _readBuffer.ActiveLength == 0,注释写明 “The server shutdown the connection on their end, likely because of an idle timeout”
- HttpConnection.cs:1680(FillAsync)—— 读到响应状态行/头中途 EOF
通过堆栈分析可以得知是第一处产生的异常,结论:请求已写完、开始读响应时,第一个读操作就返回 0(EOF),即连接在响应任何一个字节到达之前就被关闭了。
API Proposal 这里定义了一系列的 HttpRequestError 错误枚举,从 proposal 描述可以看出 ResponseEnded 是较特殊的一类,理应归类为 InvalidResponse / InvalidResponseHeader。
让我们细看 HttpClient 源码返回 ResponseEnded 的附近:
HttpConnection.cs#L606-L664 报错条件是 _readAheadTask 结束了并且 if (_readBuffer.ActiveLength == 0) 缓冲区还是没数据。
_readAheadTask 就是预读,主要在两处地方调用:从 ConnectionPool 取出连接和读取响应之前。
PrepareForReuse 就是从 ConnectionPool 取出连接的时候需要判断的预读,其核心逻辑是:
|
|
这里是异步操作,如果连接已关闭则 _readAheadTask 会立刻返回 ValueTask 结果,否则就当作正常连接交出去。
InitialFillAsync 这里则是读取响应之前需要判断的预读,它的逻辑很简单:
|
|
将底层 tcp stream 数据填充到程序的缓冲池里面。
每次 request 发送完毕之后,await _stream.ReadAsync 操作就会被内核挂起,直到对端返回数据并且内核决定刷新缓冲池,数据就会同步到程序的缓冲池里面。
之所以说是预读,是因为如果对端发送了 FIN,那么 await _stream.ReadAsync 就会立即返回,并且不带任何数据。
在应用层来说不必看到 FIN 状态,只需要知道发送了 request,响应立即返回了,但是没有数据 —— 即 ResponseEnded (EOF)。
另外,HttpClient 有个特殊逻辑,如果预读确实失活了,那么返回给 ConnectionPool 判断是否换连接进行 retry。
是否 retry 的判断条件:
|
|
而我们这里是 POST 带数据请求,不可能重试。
这就是 ResponseEnded 整个内部的细节。
HttpClient 源码分析结论:写入请求之后,预读时等待 Response 遇到了 EOF 抛出异常。
FIN & RST 那些事
恶补一下 TCP 优雅关闭、半关闭的相关知识,代理又是如何处理的。
TCP 连接关闭有 FIN 和 RST 两种情况。
下面是一个 RST 的经典示例,在尝试读取 Response 抛出:
|
|
目前我了解的几种 RST 的情况,有强制关闭主机的时候,还有代理被打爆导致无法建立 TCP 连接也会 RST。
重点是 FIN。 FIN 是优雅关闭,某一方主动关闭连接,进入四次挥手。 主动关闭连接的一方会进入 TCP 半关闭。
进入 TCP 半关闭状态后,可以接收数据,但无法写入数据。 并且如果某个响应已经开始写入,关闭是不会中断数据的,而是等数据写入完成再发送 FIN。 这个原理也能和后续分析证据串起来。
半关闭状态下,如果 client 还在尝试往 socket 写入数据,这时候对端会依据 RFC 1122 回复 RST,否则就会造成连接永久挂起等问题。 这也是我遇到这个问题时,最初猜测的高并发竞态问题,不过 ResponseEnded 并不是 RST 引起的,而是 FIN。 所以我们的目标还是不变的 —— 找出谁发的 FIN。
代理大体分为两种:
- L4(数据层):透明代理
- L7(应用层)
L7 又分为两种:
- 正向代理:HTTPS 通过 CONNECT 连接,端到端流量透传,看不到任何 HTTP 语义信息
- 反向代理:能看明文,改 XFF,自由控制长连接
Squid 我们设置为 L7 正向代理,也有空闲连接和生命周期相关的设置,不过我们也和 SRE 确认过并无特殊设置。 鉴于安全和敏感问题,很难登录代理机器排查。
根据之前对照实验,这里代理问题概率很小,可以先不看。
tcpdump
tcpdump 是 Linux 下的一个强大的抓包工具。
抓包命令:
|
|
抓取 30 分钟。
只抓 packet 前 256 个字节,过滤 tcp:3128 和 10.0.0.0/28,这是代理的内网地址。
分析原理:tcpdump 的每条连接可以按照五元组 源 IP + 源端口 + 目的 IP + 目的端口 + 传输层协议 来区分。每个 tcp packet 时序是分析的关键。
直接交给 deepseek-4.1-flash (ds4f) 开搞,方向很明确:
- 找出所有连接的年龄
- 找出是谁在关闭连接
经过一番捣鼓,过滤掉空闲连接的干扰,用 matplotlib 输出 svg,结果非常清晰。
服务器一般都会掐掉空闲连接,默认时长为一分钟,一定要过滤掉
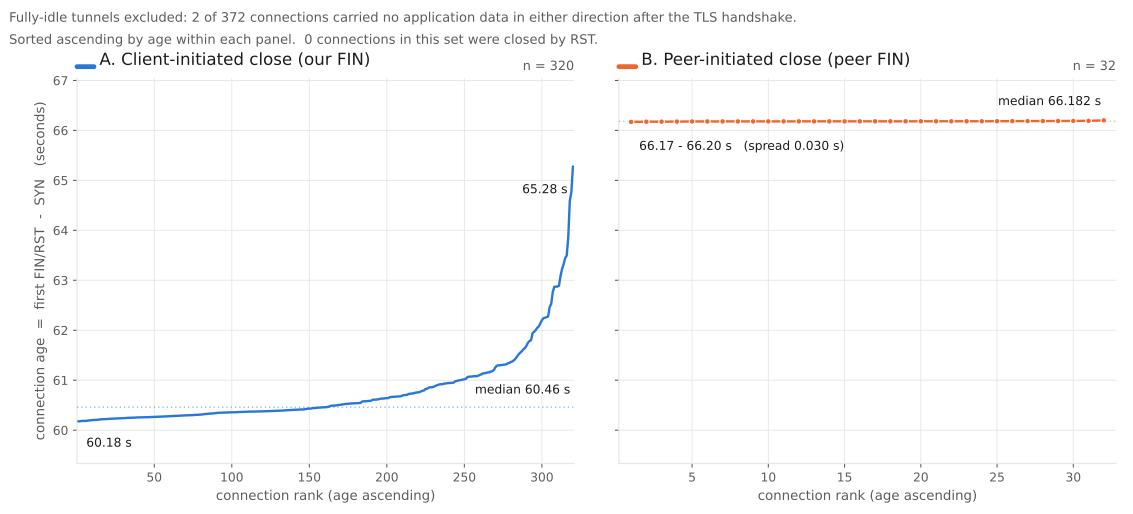
如上图所示,结果非常有意思!
- 约 90% 连接都是 HttpClient 主动 FIN 的,关闭时间在 60.18-65.28 s 指数分布。
- 约 10% 连接是对端主动 FIN 的,关闭时间在 66.17-66.20 s 聚集。
tcpdump 看不到 HTTP 层语义和 trace 异常,能力有限,不过这个分析报告给了我们极大的启发!
接下来分两部分解谜:
- HttpClient FIN
- Peer FIN
HttpClient FIN
在此之前,我们一直误以为 HttpClient 默认只会回收空闲连接,却遗忘了一种情况:对方响应携带了 Connection: Close 响应头。
该响应头通常用于 Server-side Draining —— 需要优雅回收连接的情况。
例如服务器进程关闭,阻止新建入站连接,但是还有活跃连接需要回收。
最经典的就是 Go 服务器的 Graceful shutdown,ctrl+c 不会立即退出进程,而是等待网络请求处理完成,或者连按两次 ctrl+c 强杀。
滚动发布不会排空连接。负载均衡器(L7 反向代理)会首先将机器流量降为 0,但是不会关闭 Client-LB 之间的连接,而是把新请求转发到其他服务器上。所以滚动发布对 Client 是完全无感的。
第一时间想到,这是对方服务器的一种优雅回收连接的策略。
对方配置了类似 KeepAliveLifetime=60s 的参数,那么到了 60s 之后,响应就会附加 Connection: Close 返回,如果没有请求过来,那么 66s 就直接超时发送 FIN。
之前我们写了一个 TCP 探测脚本,现在稍微修改一下,让它打印 Connection 响应头。
|
|
果然是对方在 60s 准点响应了 Connection: Close。
这就是 60s 硬中断的根因,不过和 ResponseEnded 无直接关联,让我们继续分析。
Peer FIN
对端为何会在 66s 主动发送 FIN 呢?
Nginx 文档 介绍了 keepalive_time 参数作为连接生命周期。
从 nginx 源码也发现它并不会主动 draining 连接,而是不管不顾,等 idle 超时后自动回收。
这里需要进一步分析 dotnet-trace。
之前打了很多 nettrace 文件,挑一份专看 ResponseEnded 的连接,列一个事件格栅图:
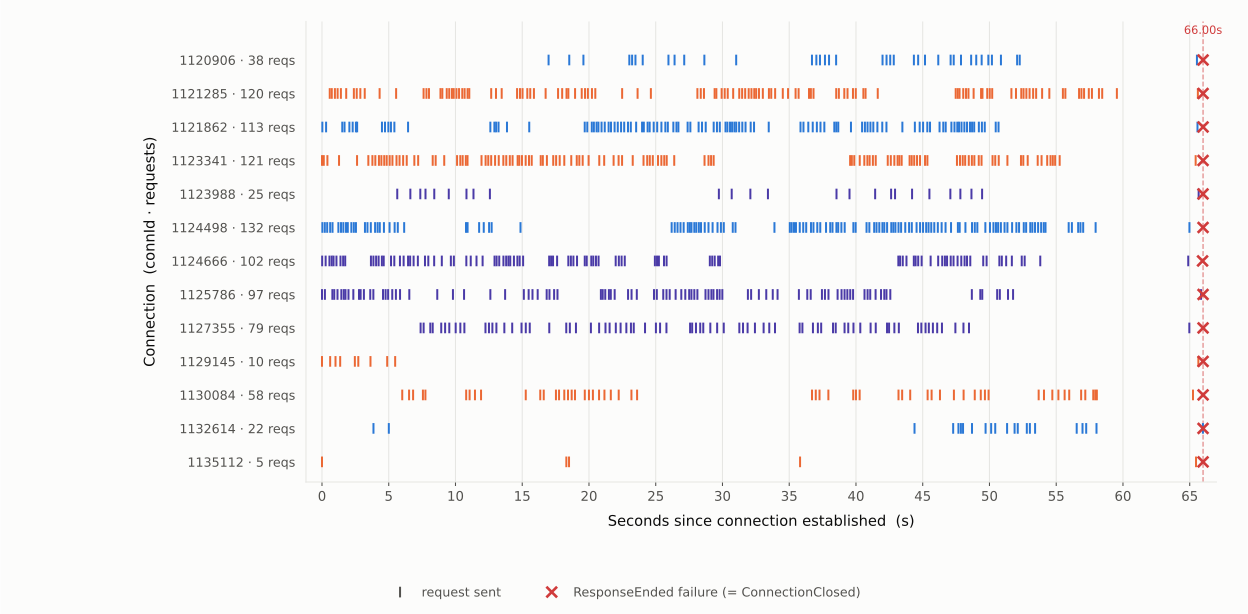
图中所示,一共 13 条连接抛 ResponseEnded,每条连接在 0-60s 都是活跃状态,只是请求数多少的区别。 共同点在于都在 60-65s 空闲,65-66s 最后发出那条请求无一例外都遇上了 ResponseEnded。 断连时间点位于 65.962 – 66.001 s 之间,极差 39 ms。
规律非常整齐!完全匹配我之前说的猜测:60s 优雅回收,60-66s 如果没有请求过来,那么 66s 就直接超时发送 FIN。
两个关闭方向
两个关闭方向:
60s->Connection: Close->Client-side FIN60s->No Request (draining 6s)->Server-side FIN
第一条路径是 60s 硬中断的根因。
第二条路径的 Server-side FIN 是 ResponseEnded 的直接原因。
抓鬼环节 - Envoy
首先探测对方到底是什么鬼服务器:
|
|
运气很好,Header 直接可以看出来是 Envoy 反代。
Envoy 正好有个 max_connection_duration 参数,并且特意提到了 drain_timeout 的设置。
接下来看 Envoy 源码,C++ 的代码太复杂了,让 ds4f 直接出结论:
|
|
这个结论也很有意思!回想之前的事件格栅图,最后一个请求是在 65-66s 期间发出的,而对方是在 66s 准点才发出 FIN。
说明对方不受理 65-66s 期间发出的请求。
其原因就和 delayed_close_timeout 参数相关,这个是 TCP 半关闭状态的一个核心参数,官方文档也给了该参数相当多的描述。 总结下来就是当连接关闭时,不会立即关闭 socket,而是转为只读状态,目的是等待对方先发送 FIN,如果没能等到才会主动发起 FIN,默认超时为 1s。
时序是这样的:
T建立了一条新连接,直到T+60都是活跃的T+60Envoy max_connection_duration 触发,尝试附加Connection: CloseT+60~65无请求T+65Envoy drain_timeout 触发,立即更改状态机 ClosingT+65~66Client 不知道连接已失活,继续发起一条请求,挂起T+66Envoy delayed_close_timeout 触发,连接仍未关闭,立即发送 FINT+66Client 收到 FIN,认为是 EOF,抛 ResponseEnded 异常
核心问题就在于 H1.1 协议下,没有 GOAWAY,也没有请求的话,Envoy 无法通知对端连接即将关闭,永远等不到 FIN。
如果对端正好在 T+65~T+66 窗口发送了请求,Envoy 是不会处理的。
66 = 60(max_connection_duration) + 5(drain_timeout) + 1(delayed_close_timeout) 等式成立,这样全文就串起来了。
这并不是一个高并发竞态的问题,而是 Envoy 的特殊行为导致的偶发故障,这也解释了为什么高并发脚本无法复现该问题。
Issue#34356 已经提到了该问题,随后的修复引入了
http1_safe_max_connection_duration参数。 开启该参数后,drain 行为就和 nginx 一致了。 然而其默认值不知为何是 false,这一点也不 sensible default。
总结
本文是笔者第一次使用 trace & tcpdump 工具去分析生产问题,过程虽曲折,但从中学习到了很多知识,而不仅仅是解决掉了一个故障。
对于长连接关闭的偶发性故障,难以使用 curl 等工具简单复现,也难以直观看出规律。 我的做法是通过 trace & tcpdump 文件分析,一步步地去探查规律。 这个过程是比较艰难的,因为文件分析需要编写大量的脚本,不过好在有 ds4f 的帮助,几乎两三天就能触及根因。 不过,这依旧是个很复杂的工作,需要有相当多的 TCP 排障经验才能闭环故障。
此外,本文还深入地探索了很多源码层的细节,这些内容虽然不会对业务有帮助,但阅读 HttpClient 源码还是比较有意思的。